
Celoexomové sekvenování je metoda umožňující analýzu oblastí kódujících proteiny, exonů a přilehlých sekvencí důležitých pro správný sestřih transkriptů.
Exony tvoří přibližně 1-2 % lidského genomu, ale obsahují značnou část variant, které přímo ovlivňují strukturu a funkci proteinů. Díky zaměření sekvenování na kódující oblasti umožňuje WES dosáhnout vysoké hloubky pokrytí zkoumané oblasti při menším objemu dat než v případě celogenomového sekvenování.
Metoda se využívá především k identifikaci zárodečných a somatických variant souvisejících s dědičnými onemocněními, vzácnými onemocněními a nádorovými procesy.
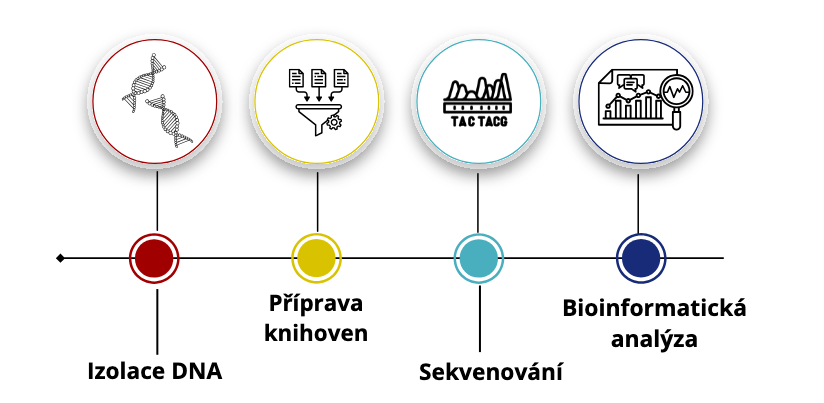
Průběh WES
Využití WES
Dostupné varianty služby WES
Dostupné strategie zachycení exomových oblastí:
- Agilent SureSelectXT Human All Exon V6 + UTR + mtDNA
- Agilent SureSelectXT Human All Exon V6 + UTR + mtDNA (s UMI)
- IDT xGen Exome Hyb Panel V2
- Standardní varianta je určena především k identifikaci zárodečných variant, jako jsou:
- SNV, tedy změny jednotlivých nukleotidů,
- malé inzerce a delece (indely),
- varianty ovlivňující kódující sekvenci nebo místa sestřihu RNA.
- WES s využitím UMI. UMI, tedy unikátní molekulární identifikátory, jsou krátké, jedinečné sekvence připojované k molekulám DNA během přípravy knihovny. Umožňují odlišit nezávislé molekuly DNA od kopií vzniklých v důsledku amplifikace PCR.
Použití UMI umožňuje:
- přesnější odstraňování duplikátů PCR,
- omezení počtu technických artefaktů,
- vytváření konsenzuálních sekvencí,
- zvýšení spolehlivosti identifikace variant s nízkou frekvencí alely,
- přesnější analýzu vzorků s omezeným množstvím DNA nebo vyžadujících vysokou hloubku sekvenování.
Technické parametry WES
Doporučená hloubka pokrytí a objem dat (output)
Požadovaný objem dat závisí na cíli projektu, kvalitě materiálu, použitém panelu a očekávané citlivosti identifikace variant.
- přibližně 5 Gb dat na vzorek: orientačně průměrná hloubka pokrytí přibližně 50×,
- přibližně 10 Gb dat na vzorek: orientačně průměrná hloubka pokrytí přibližně 100×,
- minimálně 12 Gb dat na vzorek: analýza zárodečných variant vyžadující větší hloubku sekvenování,
- minimálně 15 Gb dat na vzorek: analýza somatických variant.
Pokrytí exomu není zcela rovnoměrné. Některé oblasti mohou být méně zastoupené kvůli vysokému nebo nízkému obsahu GC, přítomnosti repetitivních sekvencí, podobnosti s jinými úseky genomu nebo omezené účinnosti hybridizace sond.
Proto se při hodnocení kvality dat analyzuje nejen průměrná hloubka sekvenování, ale také:
- podíl čtení přiřazených k cílovým oblastem - on-target,
- podíl oblastí pokrytých s hloubkou alespoň 10×, 20× nebo vyšší,
- rovnoměrnost pokrytí,
- rozložení hloubky sekvenování,
- podíl duplikátů,
- počet oblastí s nedostatečnou hloubkou pokrytí.
Požadavky na vzorky
Doporučujeme zaslat větší množství DNA, než je uvedené minimum. To umožní zopakovat kontrolu kvality nebo přípravu knihovny v případě technických problémů.
Bioinformatická analýza WES
Základní analýza
- kontrola kvality dat po sekvenování,
- odstranění adaptérů a čtení nesplňujících kritéria kvality,
- zarovnání čtení k referenčnímu genomu,
- posouzení účinnosti obohacení cílových oblastí,
- analýza průměrné hloubky a rovnoměrnosti pokrytí,
- posouzení pokrytí jednotlivých exonů a genů,
- identifikace variant SNV,
- identifikace malých inzercí a delecí,
- filtrování a anotace variant,
- stanovení předpokládaného vlivu variant na geny a kódované proteiny,
- přehled variant v tabulkové podobě.
Analýza zárodečných variant
Nad rámec základní analýzy se provádí:
- filtrování variant na základě jejich frekvence v populačních databázích,
- analýza předpokládaného vlivu varianty na funkci genu nebo proteinu,
- přehled variant popsaných v klinických a vědeckých databázích,
- analýza genů spojených s určitým fenotypem,
- analýza modelu dědičnosti,
- porovnání variant mezi členy rodiny,
- identifikace variant de novo,
- prioritizace kandidátních variant.
Zahrnutí informací o fenotypu, rodinné anamnéze a předpokládaném způsobu dědičnosti může významně zvýšit úspěšnost interpretace výsledků.
Analýza nádorových vzorků
V případě analýzy párových vzorků nádoru a nenádorového materiálu lze provést:
- identifikaci a anotaci somatických variant,
- identifikaci zárodečných variant,
- analýzu frekvence variantní alely (VAF),
- analýzu mutačního spektra,
- analýzu mutačních signatur,
- analýzu potenciálních genů řídících rozvoj nádoru,
- analýzu často mutovaných genů,
- analýzu obohacení biologických drah,
- přípravu přehledů a vizualizací rozmístění variant.
Chcete-li zjistit ceny nabízených služeb, doporučujeme vyplnit formulář specifikace projektu a/nebo si přečíst článek o cenové nabídce služeb.